Atak wielorękich bandytów
Ten post jest częścią moich zmagań z książką "Reinforcement Learning: An Introduction" autorstwa Richarda S. Suttona i Andrew G. Barto. Pozostałe posty systematyzujące moją wiedzę i prezentujące napisany przeze mnie kod można znaleźć pod tagiem Sutton & Barto i w repozytorium dloranc/reinforcement-learning-an-introduction.
Multi-armed bandit problem (albo k-armed bandit problem) jest to jeden z problemów reinforcement learningu, nie wiem czy akurat najprostszy, ale pozwala na w miarę szybkie wprowadzenie w tematykę i na zaznajomienie się z podstawowymi pojęciami.
Wyobraźmy sobie, że jesteśmy w kasynie i gramy na kilkunastu jednorękich bandytach. Automaty różnią się między sobą. Za pociągnięcie wajchy w niektórych możemy dostać większą nagrodę niż w innych. Nagroda jaką możemy otrzymać jest z pewnego rozkładu prawdopodobieństwa, raz większa, raz mniejsza. Na razie przyjmujemy, że rozkład nie zmienia się w czasie. Naszym celem jest znalezienie automatu, z którego skumulowana wartość nagród będzie największa. Musimy spędzić trochę czasu szukając dobrego automatu, ale chcemy możliwie jak najszybciej korzystać z tego najbardziej optymalnego.
To tyle jeśli chodzi o sformułowanie problemu. Powyższy przykład z automatami jest oczywiście dość sztuczny. Multi-armed bandit w praktyce może być zastosowany do takich rzeczy jak:
- próby kliniczne - by znaleźć najbardziej efektywną eksperymentalną terapię i zminimalizować negatywne efekty tych słabszych terapii na pacjentach.
- zarządzanie portfelem inwestycyjnym - by znaleźć najlepszą strategię z naszego portfela inwestycyjnego.
- zamiast testów A/B - m.in. by zmniejszyć straty konwersji, w testach A/B ruch dzielony jest równo, niezależnie od tego jak sobie radzą poszczególne wersje strony. W MAB ruch stopniowo się zmienia na rzecz najlepszej wersji.
Epsilon-greedy strategy
Ok, zaczniemy od najprostszej strategii rozwiązywania MAB jaką jest -greedy strategy. To czego szukamy to to tak zwana wartość akcji (action value). Oznaczmy akcję wybraną w kroku jako i odpowiadającą jej nagrodę jako . Wartością wybranej akcji, oznaczonej jako jest oczekiwana nagroda (średnia nagród) gdy akcja jest wybrana:
Gdybyśmy znali wartość każdej akcji łatwo moglibyśmy rozwiązać MAB, wystarczy wybierać zawsze akcję o największej wartości. Nie znamy jednak tych wartości, musimy je oszacować. Oznaczamy oszacowaną wartość akcji w czasie jako . W każdym kroku czasowym jest co najmniej jedna akcja, która ma największą wartość. Jeśli wybierzemy jakąś inną, gorszą akcję to dokonujemy eksploracji. W krótszej perspektywie czasowej tracimy wykonując tę gorszą akcję, ale liczymy na to, że w dłuższej perspektywie zgromadzimy większą skumulowaną wartość nagród, gdyby okazało się, że jednak któraś z tych gorszych akcji jest jednak lepsza od dotychczasowej najlepszej. Gromadząc wiedzę na temat wartości nagród dla każdej akcji nabieramy coraz większego przekonania, która akcja jest najlepsza poprzez eksplorację i wykorzystywanie nabytej już wiedzy. Ciekawą kwestią jest to kiedy i jak często dokonywać ekploracji i wykorzystywania nabytej wiedzy. Najprostszy sposób wykorzystuje z góry ustaloną wartość . W każdym kroku z prawdopodobieństwem wybieramy najlepszą akcję (faza wykorzystywania wiedzy, exploitation). Wyboru najlepszej akcji dokonujemy licząc po prostu zwykłą średnią arytmetyczną ze zgromadzonych nagród dla każdej akcji z osobna i wybierając tę z największą wartością. Natomiast z prawdopodobieństwem następuje eksploracja, podczas której losujemy dowolną akcję. Niezależnie od tego czy dokonujemy eksploracji czy nie, zapisujemy otrzymaną nagrodę przypisaną do wybranej akcji.
Pora na kod
Nie wiem czy wyżej wszystko jasno opisałem, ale myślę, że kod powinien rozjaśnić bardziej sprawę. Poniższy przykład zawiera klasę Bandit która wykonuje -greedy strategy dla podanych w konstruktorze trzech parametrów. Możemy ustawić dla ilu akcji (wajch), przez ile kroków czasowych i dla jakiego epsilona wykonywać algorytm. W konstruktorze następuje także inicjalizacja zmiennej true_reward losowymi wartościami, a dalej, gdy wykonywany jest algorytm, to nagrody zwracane są z wartością true_reward plus pewien szum (żeby nie było łatwo). Cała istota -greedy strategy zawiera się w metodzie choose_action. Tam następuje eksploracja/wykorzystywanie wiedzy (exploration/exploitation) z pomocą epsilona.
Kod główny (pod __main__) zawiera przykład pojedycznego przebiegu algorytmu i, co jest chyba ciekawsze, porównanie trzech różnych wartości (0, 0.1, 0.01). Wykonałem dla każdej z nich po 2000 przebiegów i uśredniłem wyniki, dzięki czemu można zobaczyć na poniższym wykresie jak dla danego epsilona wyglądają średnie nagrody w zależności od liczby iteracji.
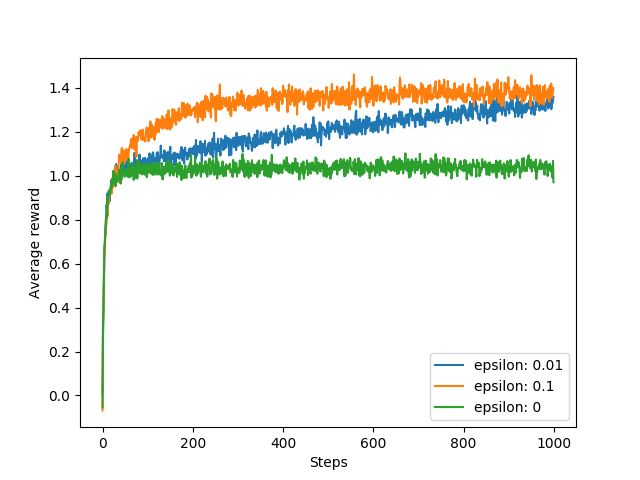
Widać, że dla wartości 0.1 optymalna akcja jest znajdowana szybko, ale nigdy nie będzie ona wybierana częściej niż przez 91% czasu. Dla wartości 0.01 optymalna akcja jest znajdowana wolniej, ale w dłuższej perspektywie osiągnie lepsze średnie wyniki.
Dobra, oto kod:
'''
Multi-armed bandit with e-greedy strategy
With saving all rewards for each arm
'''

import numpy as np
import matplotlib.pyplot as plt
from random import randint
import random


class Bandit:
    def __init__(self, arms, pulls, epsilon):
        self.arms = arms
        self.pulls = pulls
        self.epsilon = epsilon
        self.history = []

        # random values from normal distribution
        self.true_reward = [np.random.randn() for _ in range(self.arms)]
        self.rewards = [[] for _ in xrange(self.arms)]

    def get_means(self):
        means = np.zeros(self.arms)

        for index, action_rewards in zip(range(len(means)), self.rewards):
            if len(action_rewards) > 0:
                means[index] = sum(action_rewards) / len(action_rewards)

        return means

    def choose_action(self):
        rand = np.random.uniform(0, 1)

        # select action with 1 - epsilon probability
        if rand > self.epsilon:
            # exploit
            means = self.get_means()  # compute all means
            argmax = np.argmax(means) # select arm with best estimated reward
            return argmax
        else:
            # explore
            return randint(0, len(self.rewards) - 1)

    def get_reward(self, action):
        return self.true_reward[action] + np.random.randn() # true reward with noise

    def save_reward(self, action, reward):
        self.rewards[action].append(reward)

    def run(self):
        for t in range(self.pulls):
            action = self.choose_action()
            reward = self.get_reward(action)
            self.save_reward(action, reward)

            self.history.append(reward)


if __name__ == '__main__':
    # example bandit
    bandit = Bandit(arms=10, pulls=2000, epsilon=0.01)
    bandit.run()

    for arm, reward, true_reward in zip(range(1, len(bandit.rewards) + 1),
                                        bandit.rewards, bandit.true_reward):
        pulls = len(reward)
        print "Arm {} pulls: {}, true reward: {}". \
            format(arm, pulls, true_reward)

    print "Best arm: {}".format(np.argmax(bandit.true_reward) + 1)

    # experiments
    pulls = 1000
    experiments = 2000

    epsilons = [0.01, 0.1, 0]

    mean_outcomes = [np.zeros(pulls) for _ in epsilons]

    for _ in range(experiments):
        for index, epsilon in zip(range(len(epsilons)), epsilons):
            bandit = Bandit(arms=10, pulls=pulls, epsilon=epsilon)
            bandit.run()
            mean_outcomes[index] += bandit.history

    for index, epsilon in zip(range(len(epsilons)), epsilons):
        mean_outcomes[index] /= experiments
        plt.plot(mean_outcomes[index], label="epsilon: " + str(epsilon))

    plt.ylabel("Average reward")
    plt.xlabel("Steps")
    plt.legend()
    plt.savefig('01_plot.png')
Przykładowe wyjście:
Arm 1	pulls: 3,		true reward: -0.903469191365
Arm 2	pulls: 3,		true reward: 0.365839293594
Arm 3	pulls: 3,		true reward: -0.854871239295
Arm 4	pulls: 2,		true reward: -0.445679248867
Arm 5	pulls: 94,		true reward: 1.0921733926
Arm 6	pulls: 3,		true reward: -0.123881634804
Arm 7	pulls: 0,		true reward: -0.928756860211
Arm 8	pulls: 5,		true reward: 0.860238065648
Arm 9	pulls: 1885,	true reward: 1.81443343678
Arm 10	pulls: 2,		true reward: 0.247351866388
Nie zawsze jest tak różowo:
Arm 1 pulls: 1244, true reward: 0.865701931312
Arm 2 pulls: 1, true reward: -0.0986266557818
Arm 3 pulls: 2, true reward: -0.93574271516
Arm 4 pulls: 4, true reward: 0.273764997199
Arm 5 pulls: 2, true reward: -2.24599693076
Arm 6 pulls: 3, true reward: -0.0837555511977
Arm 7 pulls: 208, true reward: 0.679058209084
Arm 8 pulls: 2, true reward: -0.983193383821
Arm 9 pulls: 2, true reward: -0.0941783631123
Arm 10 pulls: 532, true reward: 1.78310799226
Podsumowanie
Przedstawiłem najprostszą strategię rozwiązywania multi-armed bandit problem znaną jako -greedy strategy. Oczywiście, jest tego o wiele więcej. Można sobie wyobrazić wartość zmniejszającą się w czasie, algorytm najpierw z fazą eksploracji i późniejszego wykorzystywania zdobytej wiedzy i wiele, wiele innych strategii. Ale o tym w kolejnych postach.